Predykcyjne utrzymanie ruchu w przemyśle: jak przewidywać awarie, zanim zatrzymają produkcję
W przemyśle czas ma swoją cenę. Każda nieplanowana przerwa na linii produkcyjnej oznacza nie tylko nerwy, ale też realne straty, opóźnienia i kłopoty z realizacją zamówień. Właśnie dlatego coraz więcej zakładów odchodzi od prostego reagowania na awarie i stawia na podejście, które pozwala zobaczyć problem wcześniej, zanim urządzenie zacznie szwankować.
Predykcyjne utrzymanie ruchu nie jest modnym hasłem z prezentacji dla zarządu. To konkretna metoda pracy, oparta na danych, analizie stanu maszyn i wyłapywaniu sygnałów ostrzegawczych. W praktyce daje firmom coś bardzo cennego: czas. A w fabryce czas bywa ważniejszy niż większość deklaracji o „optymalizacji” i „transformacji cyfrowej”.
Na czym polega predykcyjne utrzymanie ruchu
Najprościej mówiąc, chodzi o przewidywanie momentu, w którym maszyna może ulec awarii albo wejść w stan podwyższonego ryzyka. Zamiast czekać, aż łożysko się rozsypie, a silnik zacznie się przegrzewać, system zbiera dane z czujników i szuka odchyleń od normalnej pracy. Jeśli coś zaczyna odbiegać od wzorca, zespół utrzymania ruchu dostaje sygnał, że warto sprawdzić urządzenie.
W odróżnieniu od reaktywnego podejścia nie chodzi tu o gaszenie pożaru, lecz o wyłapywanie jego pierwszych iskier. W odróżnieniu od klasycznego utrzymania prewencyjnego nie opiera się także wyłącznie na sztywnym kalendarzu przeglądów. Maszyna nie trafia na serwis dlatego, że minęło 500 godzin pracy, lecz dlatego, że jej parametry wskazują na realne zużycie albo nieprawidłowość.
To podejście jest szczególnie wartościowe w zakładach, gdzie jedna awaria potrafi zatrzymać cały ciąg technologiczny. W przemyśle spożywczym, chemicznym, motoryzacyjnym czy hutniczym przestój pojedynczego elementu często pociąga za sobą efekt domina. I właśnie tam przewidywanie problemów ma największy sens.
Skąd bierze się ta zmiana w podejściu do maszyn
Przez lata dominował prosty model: maszyna działa, więc nie ruszamy. Potem pojawił się drugi etap, czyli serwis według harmonogramu. To był postęp, ale nie idealny. Czasem urządzenie wymagało interwencji wcześniej, a czasem było serwisowane zbyt wcześnie, choć nadal pracowało bez zarzutu. Oba scenariusze generowały koszty.
Współczesny przemysł działa pod większą presją niż dawniej. Firmy muszą produkować szybciej, dokładniej i taniej, a jednocześnie spełniać wymagania jakościowe oraz środowiskowe. Do tego dochodzi rosnąca złożoność parków maszynowych. W jednej hali spotykają się maszyny starsze, pamiętające jeszcze czasy analogowych nastaw, i nowe urządzenia naszpikowane elektroniką oraz oprogramowaniem.
Polskie firmy też nie stoją z boku. Duże przedsiębiorstwa z branży energetycznej, chemicznej, spożywczej czy transportowej inwestują w monitoring stanu maszyn, bo wiedzą, że jeden nieplanowany postój potrafi wyczyścić budżet szybciej niż niejeden koszt inwestycyjny. Wystarczy spojrzeć na zakłady działające w modelu ciągłym, gdzie zatrzymanie linii nie jest zwykłą usterką, tylko poważnym problemem operacyjnym.
Jak działa taki system w praktyce
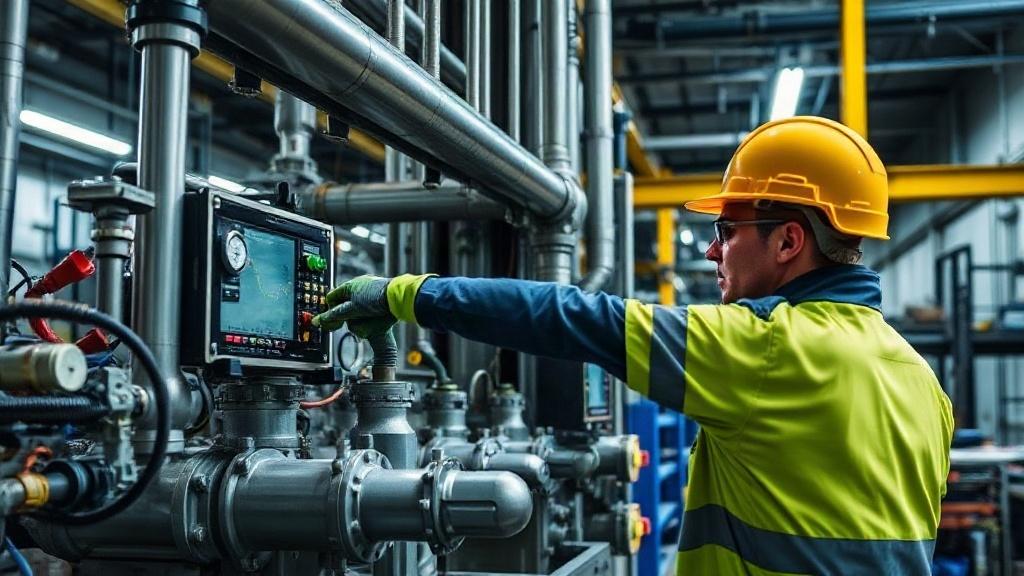
Podstawą są dane. Czujniki zbierają informacje o temperaturze, drganiach, ciśnieniu, prądzie pobieranym przez silnik, hałasie, wilgotności czy jakości smaru. W zależności od typu maszyny zestaw pomiarów może być inny, ale sens pozostaje ten sam: śledzić zachowanie urządzenia w czasie rzeczywistym.
Następnie dane trafiają do systemu analitycznego. Tam są porównywane z historycznymi wzorcami pracy, normami producenta albo modelem wypracowanym na podstawie wcześniejszych awarii. Jeśli algorytm zauważy, że np. amplituda drgań rośnie w sposób typowy dla zużycia łożyska, może oznaczyć urządzenie jako wymagające diagnostyki.
Ważne jest to, że sam sygnał nie oznacza jeszcze awarii. To raczej ostrzeżenie. Dobrze wdrożony system nie straszy bez powodu, tylko pokazuje, które urządzenia wymagają uwagi, jak pilny jest problem i jakie czynności warto wykonać jako pierwsze. W praktyce pomaga to technikom lepiej planować pracę, zamawiać części z wyprzedzeniem i unikać chaotycznych interwencji.
Najczęstsze źródła danych
W zakładach przemysłowych najczęściej wykorzystuje się kilka grup danych. Każda z nich mówi coś innego o stanie maszyny, a dopiero razem tworzą pełniejszy obraz sytuacji. To trochę jak z diagnozą u lekarza: sam pomiar temperatury nie wystarczy, jeśli nie wiadomo, co dzieje się z resztą organizmu.
- drgania i wibracje silników, pomp, przekładni oraz łożysk,
- temperatura elementów roboczych i układów napędowych,
- natężenie prądu i zmiany obciążenia,
- ciśnienie i przepływ w układach hydraulicznych oraz pneumatycznych,
- oleje i środki smarne, ich lepkość, zanieczyszczenie i stan chemiczny,
- dane z systemów sterowania PLC i SCADA,
- historia napraw, wymian części i przestojów.
W dobrze zorganizowanym zakładzie te źródła nie działają osobno. Ich połączenie daje dużo lepszy obraz niż pojedynczy czujnik przyklejony do obudowy silnika. I właśnie na tym polega siła takiego podejścia: nie na jednym magicznym pomiarze, lecz na złożeniu wielu drobnych sygnałów w sensowną całość.
Różnica między podejściem reaktywnym, prewencyjnym i predykcyjnym
Warto rozdzielić te trzy modele, bo w rozmowach branżowych często wrzuca się je do jednego worka. To błąd, bo każdy działa inaczej i daje inne efekty. Reaktywne utrzymanie ruchu polega na naprawie dopiero po awarii. Jest najprostsze, ale też najbardziej kosztowne w skutkach.
Utrzymanie prewencyjne zakłada planowe przeglądy i wymiany części według harmonogramu. To już lepsze rozwiązanie, bo zmniejsza ryzyko niespodzianek. Problem w tym, że harmonogram nie zawsze odzwierciedla rzeczywisty stan urządzenia. Jedne maszyny dostają zbyt wcześnie nowy komponent, inne psują się szybciej, niż przewidziano w kalendarzu.
Predykcyjne utrzymanie ruchu stara się trafić dokładniej. Wykorzystuje dane ze środowiska pracy i historię eksploatacji, by określić, kiedy interwencja ma sens. Nie wymaga też bezsensownego rozbierania sprawnej maszyny tylko dlatego, że minęło określone tyle a tyle godzin pracy. To nie tylko oszczędność pieniędzy, ale też mniej niepotrzebnego stresu dla zespołu technicznego.
Dlaczego duże zakłady tak chętnie po to sięgają
Duże przedsiębiorstwa mają rozbudowany park maszynowy, a każdy przestój kosztuje je więcej niż małą firmę. Jeśli jedna linia zatrzyma produkcję opakowań, po kilku godzinach problem zaczyna się rozlewać na logistykę, magazyn i sprzedaż. W takich warunkach nawet niewielka poprawa niezawodności daje wymierny efekt.
Jest też druga sprawa: skala. Tam, gdzie pracują setki maszyn, nie da się wszystkiego doglądać wyłącznie „na słuch” i „na oko”, choć doświadczeni mechanicy wciąż mają w tym ogromną wartość. Potrzebne są narzędzia, które odciążą ludzi od rutyny i pozwolą im skupić się na najważniejszych przypadkach. Właśnie dlatego rozwiązania oparte na analizie danych zaczęły wchodzić do dużych zakładów tak szybko.
W Polsce takie podejście wdrażają m.in. firmy z branży energetycznej i produkcyjnej, w tym duże grupy kapitałowe z wieloletnią tradycją. W ich przypadku awaria turbiny, pompy czy instalacji pomocniczej nie jest drobną niedogodnością, tylko potencjalnym problemem całego systemu. Dlatego monitoring stanu technicznego przestał być ciekawostką, a stał się narzędziem zarządzania ryzykiem.
Jakie korzyści daje takie podejście
Najbardziej oczywista korzyść to ograniczenie nieplanowanych przestojów. Jeśli zespół widzi, że element zużywa się szybciej niż zwykle, może zaplanować wymianę w dogodnym momencie, na przykład podczas postoju technologicznego. To bardzo prosta różnica, ale w praktyce potrafi uratować całą zmianę produkcyjną.
Drugą korzyścią jest lepsze wykorzystanie zasobów. Mechanicy nie muszą sprawdzać wszystkich urządzeń według tego samego schematu, tylko zajmują się tymi, które rzeczywiście tego wymagają. Magazyn części zamiennych także zaczyna pracować rozsądniej, bo zamówienia można planować z większą precyzją. Mniej leży, mniej się kurzy, mniej zamraża pieniądze.
Nie bez znaczenia jest także bezpieczeństwo. Maszyna, która wykazuje niepokojące objawy, może stanowić zagrożenie dla operatorów. Dotyczy to zwłaszcza urządzeń wirujących, wysokotemperaturowych i pracujących pod ciśnieniem. Wykrycie problemu wcześniej oznacza mniejsze ryzyko wypadku i mniej sytuacji granicznych.
Najważniejsze efekty dla zakładu
| Obszar | Co się poprawia |
|---|---|
| Produkcja | Mniej przestojów i lepsza ciągłość pracy |
| Serwis | Bardziej celowane interwencje i lepsze planowanie zadań |
| Magazyn | Lepsze zarządzanie częściami zamiennymi |
| Finanse | Niższe koszty awarii i mniej niepotrzebnych wymian |
| Bezpieczeństwo | Mniejsze ryzyko pracy na uszkodzonych urządzeniach |
Tabela wygląda prosto, ale za każdą z tych pozycji stoi konkretna oszczędność czasu, energii i pieniędzy. I to właśnie sprawia, że firmy nie traktują już takiego systemu jako dodatku, lecz jako część podstawowego zarządzania produkcją.
Gdzie predykcja działa najlepiej
Najwięcej zyskują zakłady, w których awaria jednej maszyny szybko zatrzymuje resztę procesu. Dobrym przykładem są linie ciągłe, gdzie surowiec przechodzi przez kolejne etapy bez dłuższych przerw. Jeżeli jeden element zawiedzie, reszta systemu często nie ma jak pracować dalej.
Świetnie sprawdza się to również tam, gdzie urządzenia są kosztowne, a ich wymiana trwa długo. W zakładach chemicznych, energetycznych, papierniczych i metalurgicznych przerwy serwisowe trzeba planować z wyprzedzeniem. Każde ostrzeżenie pojawiające się wcześniej daje więcej przestrzeni do działania.
Warto też wspomnieć o branżach, w których liczy się jakość wyrobu. Jeśli maszyna zaczyna pracować niestabilnie, efekt może być widoczny nie tylko w awarii, ale też w spadku jakości produktu. A to już zupełnie inny koszt, bo nie chodzi wyłącznie o naprawę urządzenia, ale też o odpad, reklamację lub ryzyko utraty klienta.
Jakie technologie stoją za tym podejściem
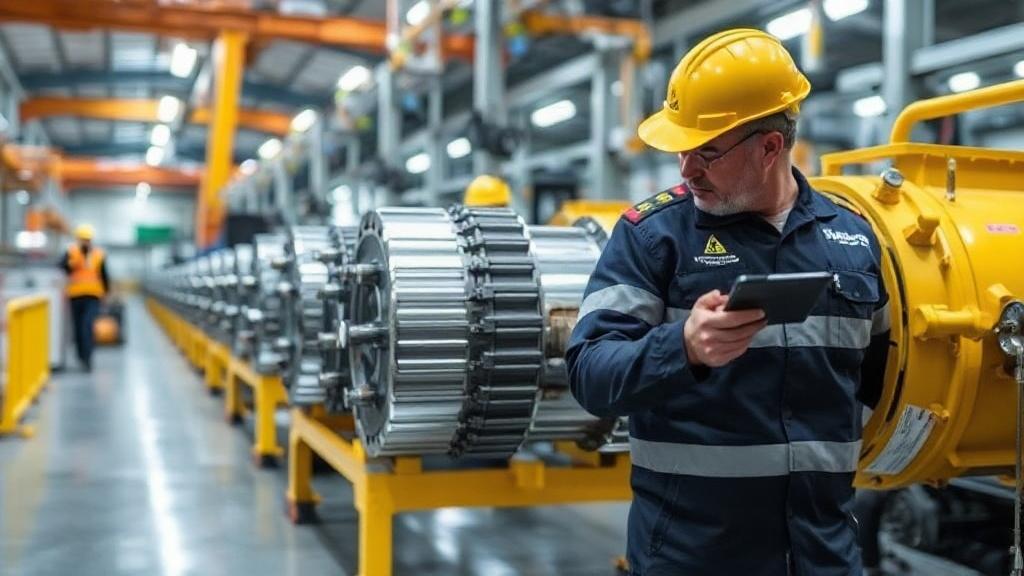
Na pierwszy plan wysuwają się czujniki przemysłowe, ale to dopiero początek. Same sensory nie wystarczą, jeśli nie ma systemu, który potrafi zinterpretować dane. Dlatego ważną rolę odgrywa oprogramowanie analityczne, platformy zbierania danych, chmura obliczeniowa i algorytmy uczenia maszynowego.
W wielu zakładach dane spływają do systemów SCADA, MES lub CMMS. Dzięki temu można połączyć informację o stanie technicznym z rzeczywistym przebiegiem produkcji i historią konserwacji. Taki zestaw jest o wiele bardziej użyteczny niż luźne wykresy rozproszone po kilku działach.
Coraz częściej pojawiają się też rozwiązania wykorzystujące sztuczną inteligencję. Ich zadaniem jest wykrywanie wzorców, których człowiek nie zauważyłby na pierwszy rzut oka. To ważne zwłaszcza wtedy, gdy liczba urządzeń i zmiennych jest tak duża, że ręczna analiza przestaje być praktyczna. Nie chodzi jednak o zastąpienie ludzi, tylko o lepsze wykorzystanie ich doświadczenia.
Rola człowieka nie znika
Wbrew niektórym entuzjastycznym opisom cyfryzacji, predykcyjne utrzymanie ruchu nie działa samo z siebie. To nie jest automat, który po prostu „wie wszystko”. Ktoś musi ustawić sensowne progi alarmowe, ktoś musi sprawdzić wyniki, ktoś musi podjąć decyzję o zatrzymaniu maszyny.
W praktyce największą wartość mają doświadczeni technicy i inżynierowie, którzy potrafią odróżnić realne zagrożenie od szumu w danych. System może wskazać anomalię, ale to człowiek nadaje jej znaczenie. Bez takiej weryfikacji łatwo popaść w drugą skrajność: albo ignorować alarmy, albo reagować na każdy drobiazg.
To właśnie połączenie wiedzy praktycznej i analizy danych daje najlepszy efekt. Mechanik słyszy nietypowy dźwięk, system pokazuje wzrost drgań, a historyczne dane sugerują zużycie łożyska. Dopiero razem tworzą obraz, który można traktować poważnie. Samodzielnie każdy z tych sygnałów bywa zbyt słaby.
Jak wygląda wdrożenie w zakładzie
Nie zaczyna się od kupna drogich czujników i hasła „będziemy predykcyjni od przyszłego tygodnia”. To tak nie działa. Najpierw trzeba zrozumieć, które urządzenia są krytyczne, gdzie awaria boli najbardziej i jakie dane w ogóle mają sens. Bez tego łatwo wydać pieniądze na system, który będzie zbierał ciekawostki zamiast użytecznych informacji.
Wdrożenie zwykle zaczyna się od audytu parku maszynowego. Trzeba wskazać maszyny kluczowe dla produkcji, ustalić typowe tryby awarii, sprawdzić dostępność danych i określić, co faktycznie da się mierzyć. Dopiero potem wybiera się czujniki, oprogramowanie i sposób integracji z istniejącą infrastrukturą.
Na końcu przychodzi etap testów. To ważny moment, bo system trzeba nauczyć odróżniać stan normalny od niepokojącego. W pierwszych miesiącach często pojawia się sporo fałszywych alarmów albo odwrotnie, sygnały są zbyt słabe. Kalibracja i cierpliwość są tu ważniejsze niż marketingowe obietnice dostawcy.
Kolejność działań przy wdrożeniu
- Wybór maszyn krytycznych dla procesu.
- Analiza awarii, przestojów i kosztów utrzymania.
- Dobór czujników i metod zbierania danych.
- Integracja z systemami zakładowymi.
- Testy, kalibracja i dopracowanie progów alarmowych.
- Szkolenie zespołu utrzymania ruchu.
- Stała analiza efektów i korekty modelu.
Ta kolejność nie jest przypadkowa. Jeśli pominie się pierwszy albo drugi krok, reszta robi się krucha. A wtedy łatwo dojść do wniosku, że „system nie działa”, choć tak naprawdę źle zdefiniowano cel jego wdrożenia.
Najczęstsze błędy przy wdrażaniu
Pierwszy błąd to wiara, że sama technologia załatwi problem. Nie załatwi. Jeśli w firmie nie ma porządku w dokumentacji awarii, nie spisuje się historii napraw albo dane z maszyn są rozproszone po różnych działach, system analityczny dostaje chaotyczny materiał. Z chaosu trudno wyciągać trafne wnioski.
Drugi błąd to przesadne oczekiwania wobec algorytmów. Nie każda anomalia oznacza awarię, a nie każdy brak alarmu oznacza pełne bezpieczeństwo. System musi być traktowany jako narzędzie wsparcia, a nie wyrocznia. Jeśli tego zabraknie, szybko pojawia się frustracja i spada zaufanie użytkowników.
Trzecim problemem bywa zbyt szeroki start. Nie ma sensu obejmować monitoringiem całego zakładu naraz, jeśli organizacja nie ma jeszcze doświadczenia w pracy z takimi danymi. Lepiej zacząć od kilku kluczowych maszyn, dopracować proces i dopiero później rozszerzać zakres. W przeciwnym razie projekt może utknąć w gąszczu danych bez realnego efektu.
Co decyduje o sukcesie
Najważniejsza jest sensowna selekcja urządzeń. Nie wszystko trzeba monitorować z taką samą intensywnością. W zakładzie zawsze znajdą się maszyny krytyczne, ważne i poboczne. Predykcja powinna przede wszystkim obejmować te pierwsze, bo tam potencjalny zysk jest największy.
Drugą sprawą jest jakość danych. Jeśli czujnik jest źle zamontowany, a odczyty zakłóca środowisko pracy, wynik będzie niewiarygodny. W przemyśle nie wystarczy „mieć dane”. Trzeba jeszcze wiedzieć, czy można im zaufać. To brzmi banalnie, ale właśnie na tym potyka się wiele projektów.
Trzecim elementem jest współpraca między działami. Utrzymanie ruchu, produkcja, automatyka, magazyn i zarząd muszą mówić do siebie jednym językiem. Bez tego ostrzeżenia z systemu mogą zostać zignorowane albo źle zinterpretowane. A wtedy cała inwestycja zaczyna wyglądać jak drogi gadżet.
Gdzie w tym wszystkim mieszczą się duże polskie przedsiębiorstwa
Duże polskie firmy coraz częściej wykorzystują monitoring stanu maszyn nie dlatego, że dobrze wygląda w prezentacji, ale dlatego, że daje przewagę. W branżach o wysokiej skali produkcji, takich jak energetyka, chemia, przetwórstwo spożywcze czy transport, każda godzina postoju kosztuje bardzo dużo. Z tego powodu narzędzia oparte na przewidywaniu awarii stają się częścią codziennego zarządzania, a nie projektem „na później”.
Warto też zauważyć, że polski przemysł ma sporą różnorodność. Obok nowoczesnych zakładów są firmy, które pracują na starszym parku maszynowym, ale właśnie tam predykcja potrafi zrobić ogromną różnicę. Nie trzeba mieć najnowszej fabryki, żeby korzystać z analizy stanu technicznego. Czasem wystarczy dobra diagnoza, sensowny pomiar i konsekwencja w działaniu.
To interesujące, że wiele przedsiębiorstw dopiero po pierwszych wdrożeniach zaczyna widzieć pełną wartość takiego podejścia. Najpierw liczą oszczędności z jednego unikniętego przestoju, potem dochodzą mniejsze koszty części, a na końcu okazuje się, że poprawiła się też organizacja pracy całego działu technicznego. Efekt bywa szerszy, niż początkowo zakładano.
Jak mierzyć efekty takiego rozwiązania
Najprościej przez redukcję przestojów, ale to nie jedyny wskaźnik. Warto patrzeć także na czas reakcji serwisu, liczbę awarii krytycznych, koszty części zamiennych oraz średni czas między awariami. Dopiero taki zestaw pokazuje, czy system rzeczywiście działa, czy tylko produkuje kolejne wykresy.
Przydatny jest również wskaźnik OEE, jeśli zakład go stosuje. Gdy poprawia się dostępność urządzeń, zwykle widać to właśnie w tym obszarze. Jednak nie należy ograniczać się do jednego parametru, bo czasem poprawa w jednym miejscu maskuje problem w innym. Na przykład mniej awarii może oznaczać więcej planowanych postojów, ale jeśli są dobrze zaplanowane, wynik nadal jest korzystny.
W praktyce warto również analizować liczbę fałszywych alarmów. Jeśli system zbyt często zgłasza zagrożenie, ludzie przestają go słuchać. To jeden z najgroźniejszych scenariuszy, bo z pozoru wszystko działa, a zaufanie do narzędzia po cichu się rozpada.
Co może pójść źle i dlaczego to nie znaczy, że pomysł jest słaby
Nie każdy projekt kończy się sukcesem od razu. Czasem problemem jest brak danych historycznych, czasem złe ustawienie czujników, a czasem zwykły pośpiech. To nie przekreśla samej metody. Raczej pokazuje, że przemysł nie lubi skrótów i każda dobra decyzja musi być osadzona w realnym procesie.
Bywa też, że firma oczekuje efektu w kilka tygodni, a taki system potrzebuje czasu, by nauczyć się normalnej pracy maszyn. Szczególnie przy złożonych urządzeniach dane muszą „dojrzeć”, zanim będą naprawdę użyteczne. To trochę jak z nowym pracownikiem: nie od razu zna wszystkie niuanse zakładu.
Warto przy tym pamiętać, że nawet niedoskonałe wdrożenie może być cenną lekcją. Pokazuje, gdzie brakuje dokumentacji, które maszyny są najbardziej wrażliwe i jak działają zespoły serwisowe. Czasem już sam audyt daje firmie więcej porządku niż niejedna prezentacja strategii.
Dlaczego ten temat będzie jeszcze ważniejszy
Przemysł coraz mocniej opiera się na danych, automatyzacji i łączeniu maszyn w spójne systemy. Im bardziej złożona produkcja, tym większa potrzeba wcześniejszego wykrywania problemów. W takim świecie serwis wykonywany „na wyczucie” po prostu przestaje wystarczać.
Do tego dochodzi presja na efektywność energetyczną i ograniczanie strat. Maszyna, która pracuje gorzej niż powinna, często zużywa więcej energii, pogarsza jakość procesu i zwiększa ryzyko awarii. Predykcja pomaga wyłapywać takie zjawiska wcześniej, zanim zamienią się w kosztowny problem.
Można więc powiedzieć, że przyszłość utrzymania ruchu nie polega na rezygnacji z doświadczenia ludzi, lecz na jego wsparciu narzędziami, które widzą więcej i szybciej. A to w przemyśle jest po prostu rozsądne. Tam nie wygrywa ten, kto głośniej obiecuje, tylko ten, kto potrafi utrzymać maszynę w ruchu bez zbędnych przerw.
Jak patrzeć na to rozwiązanie bez marketingowej mgły
Najuczciwiej traktować predykcyjne utrzymanie ruchu jako praktyczny sposób zarządzania ryzykiem technicznym. Nie jest to cudowne lekarstwo na wszystkie awarie i nie zastępuje solidnej obsługi maszyn. Daje jednak coś bardzo konkretnego: lepszą widoczność stanu urządzeń i większą kontrolę nad momentem interwencji.
Dla jednych zakładów będzie to krok milowy, dla innych stopniowe usprawnienie istniejących procedur. W obu przypadkach sens pozostaje ten sam. Chodzi o to, by nie dowiadywać się o problemie wtedy, gdy linia już stoi, tylko chwilę wcześniej, gdy da się jeszcze spokojnie zareagować.
I właśnie dlatego to podejście tak dobrze wpisuje się w nowoczesny przemysł. Łączy twarde dane z praktyką warsztatu, a technologię z doświadczeniem ludzi, którzy na co dzień pilnują, by maszyny nie miały prawa się obrazić. W fabryce to zwykle najlepszy układ.